A jornada para o desenvolvimento agêntico: desenvolvendo um encurtador de URLs
Tempo de leitura: 20 minutos.
Imagem gerada por IA.
Introdução
Se você tentar compartilhar este post, vai notar que a URL de compartilhamento está encurtada, e usa um domínio só meu: mcbs.cc. Isso não é um detalhe de design. É o resultado de um experimento que conduzi com uma aplicação real, para sentir em primeira mão os limites e os desdobramentos do desenvolvimento agêntico, aquele em que agentes de IA planejam, escrevem, testam e publicam o software.
Como executivo, escrever software não é o meu dia a dia. Mas decidir como a minha organização vai adotar essa tecnologia é, e não dá para conduzir uma estratégia de adoção só com apresentações de fornecedores e relatos de terceiros. Eu precisava sentir o processo com as minhas próprias mãos, num problema que eu realmente tinha.
O problema era simples. Depois do revamp deste site, comecei a compartilhar os conteúdos no LinkedIn, no X e no WhatsApp, e os links eram longos demais. Tentei os serviços tradicionais de encurtamento, TinyURL e Bitly, e percebi que todos tinham migrado para modelos pagos, protegidos por tela de login. Não era sustentável, e principalmente não era automatizável: eu queria que todo conteúdo do site nascesse com um link curto, sem que eu precisasse lembrar de gerá-lo.
Decidi fazer eu mesmo. E fiz com uma regra: não escrever uma única linha de código. Toda a construção foi feita por IA, comigo no
papel de piloto: decidindo, aprovando, validando. Usei o modelo mais adequado para cada etapa, e exigi que a solução rodasse nos planos
gratuitos da Cloudflare e do GitHub. Procurei um domínio curto, ligado ao meu sobrenome, e encontrei o mcbs.cc disponível por
US$ 8,00. Registrei pela própria Cloudflare e comecei a jornada.
Este post conta o que foi construído, como, quanto custou e quanto tempo levou, o que deu errado, e o que isso me ensinou sobre adoção. Vou deixar os números na mesa, porque acho que a conversa sobre IA no desenvolvimento está cheia de impressão e pobre em dados.
A tese em um parágrafo
Em cerca de 5 horas de trabalho ativo, com zero linhas escritas por mim, saiu um serviço completo em produção: redirecionamento de links, API, geração de QR Code, painel administrativo protegido, ferramenta de linha de comando, backup diário, monitoramento e integração automática com o meu blog. São 5.888 linhas de código de produção e 3.407 linhas de teste, com cobertura de 96% do que é testável. Custo de infraestrutura: zero, fora o domínio. Custo da IA: US$ 57,87. O desenvolvimento agêntico funciona. Mas o que o torna confiável não é o modelo, é o processo ao redor dele, e é nisso que quero me concentrar.
1. O produto: o que eu queria
Quatro requisitos, escritos na primeira mensagem ao agente de planejamento:
- encurtar qualquer URL, com link aleatório ou personalizado (
mcbs.cc/palestra); - gerar um QR Code para cada link;
- um painel para eu gerenciar tudo, e uma linha de comando para quem vive no terminal;
- integração com o blog: todo conteúdo novo ganha link curto e QR sozinho, no deploy.
E duas restrições que, no fim, definiram a arquitetura: rodar só em planos gratuitos e ser simples de operar sozinho.
2. A arquitetura, em uma página
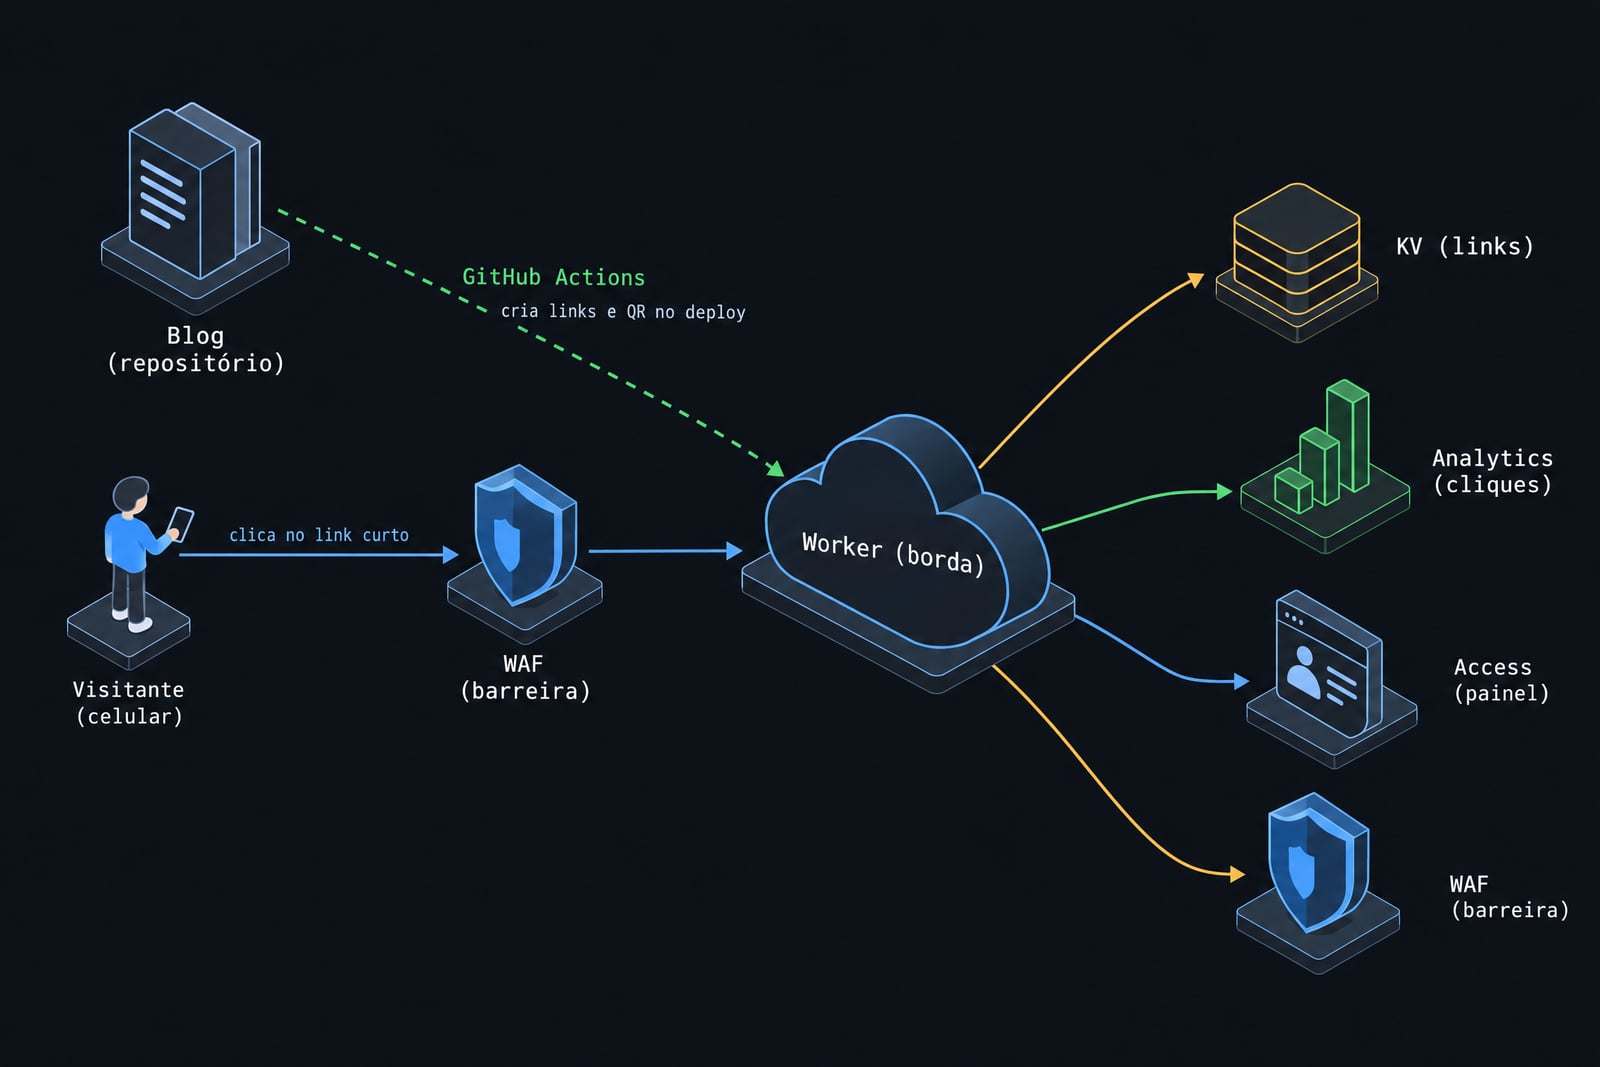
Imagem gerada por IA.
O serviço inteiro é um único Worker da Cloudflare, que roda na borda da rede, perto de quem clica, sem servidor para administrar.
| Peça | O que faz | Por que essa escolha |
|---|---|---|
| Cloudflare Workers (Hono + TypeScript) | Todo o código: redirect, API, QR, painel | Sem servidor, sem custo no volume de um site pessoal |
| Workers KV | Guarda os links (slug → destino) | Leitura muito rápida e barata; consistência eventual (~1 min) aceitável |
| Analytics Engine | Conta cliques, sem IP nem cookie | Estatística sem armazenar dado pessoal |
| Cloudflare Access | Protege o painel (/admin) com código por e-mail |
Login pronto, sem eu construir autenticação |
| WAF (regra de rate limit) | Limita 300 requisições por 10 s por IP | Primeira barreira contra abuso e varredura |
| GitHub Actions | CI, backup diário do KV, monitor horário, e geração dos links do blog | Automação que roda sem eu lembrar |
| Workers Builds | Publica a cada push na main (~40 s) |
Deploy sem pipeline próprio |
Duas decisões merecem destaque porque são o tipo de escolha que o agente propôs e eu aprovei:
- O QR Code é gerado na hora, nunca armazenado. Menos coisas guardadas, menos coisas que quebram.
- Link desconhecido, arquivado ou expirado redireciona para o blog, sem página de erro. Para quem escaneou um QR impresso, cair no site é sempre melhor do que cair num 404.
3. O método: dois agentes, duas sessões
O processo foi em duas sessões, e a divisão é a lição mais transferível do experimento.
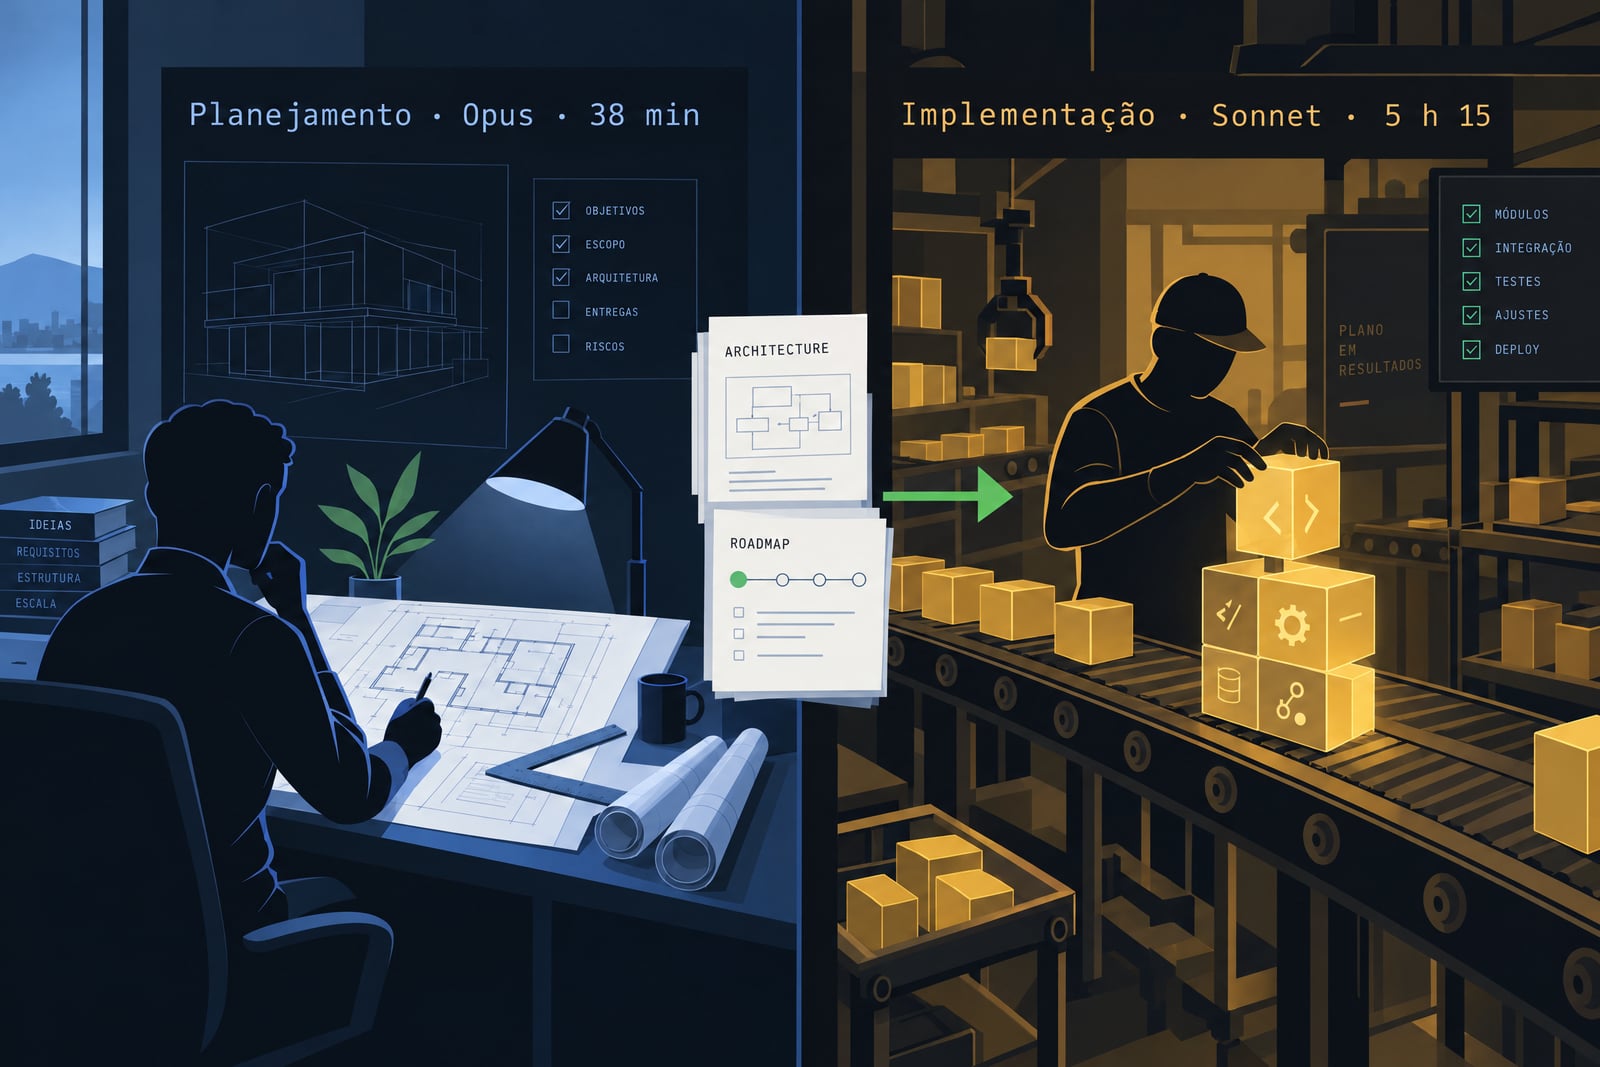
Imagem gerada por IA.
Sessão 1: planejamento (Opus 5.5, esforço alto): 38 minutos. Nada de código. A instrução foi “não implemente nada, desenhe a arquitetura”. O agente consultou a documentação dos limites dos planos gratuitos antes de decidir, e entregou três documentos: uma arquitetura com 8 decisões registradas (cada uma com alternativas e motivo), um roteiro de 7 fases com critério de aceite e um índice. Eu respondi a quatro perguntas de escopo (cliques entram? painel com framework? links expiram? como é o 404?) e questionei uma: o plano propunha links de 7 caracteres; perguntei “por que não mais curto?”, e viraram 5, com a conta do espaço de combinações.
Sessão 2: implementação (Sonnet 5.5, esforço variando de baixo a alto): ~5 h 15 min. Um modelo mais econômico executando um plano específico. Esforço baixo para tarefas mecânicas, alto para o que exigia julgamento (segurança, o QR, a integração com o blog). Foram ~490 respostas, 845 mil tokens gerados (pelo medidor de uso) e cerca de 60 mensagens minhas, quase todas curtas: uma decisão, um “pode seguir”, uma captura de tela.
Para executivos: a economia não está em usar o melhor modelo em tudo, nem o mais barato em tudo. Está em pensar caro e executar barato, com um plano bom no meio.
4. O ritmo, e uma linha do tempo honesta
- 23/10, 23:59: plano pronto e commitado.
- 24/10, 00:23 a 03:43 (~3 h 20): fases 0 a 5. Fundação e deploy, redirect, links personalizados, QR, painel com login, linha de comando, backup diário, atalho para o iPhone.
- 25/10, 04:07 a 05:57 (~1 h 50): integração com o blog (96 links criados num backfill), pré-visualização do destino, tags e filtros no painel, alerta de falha.
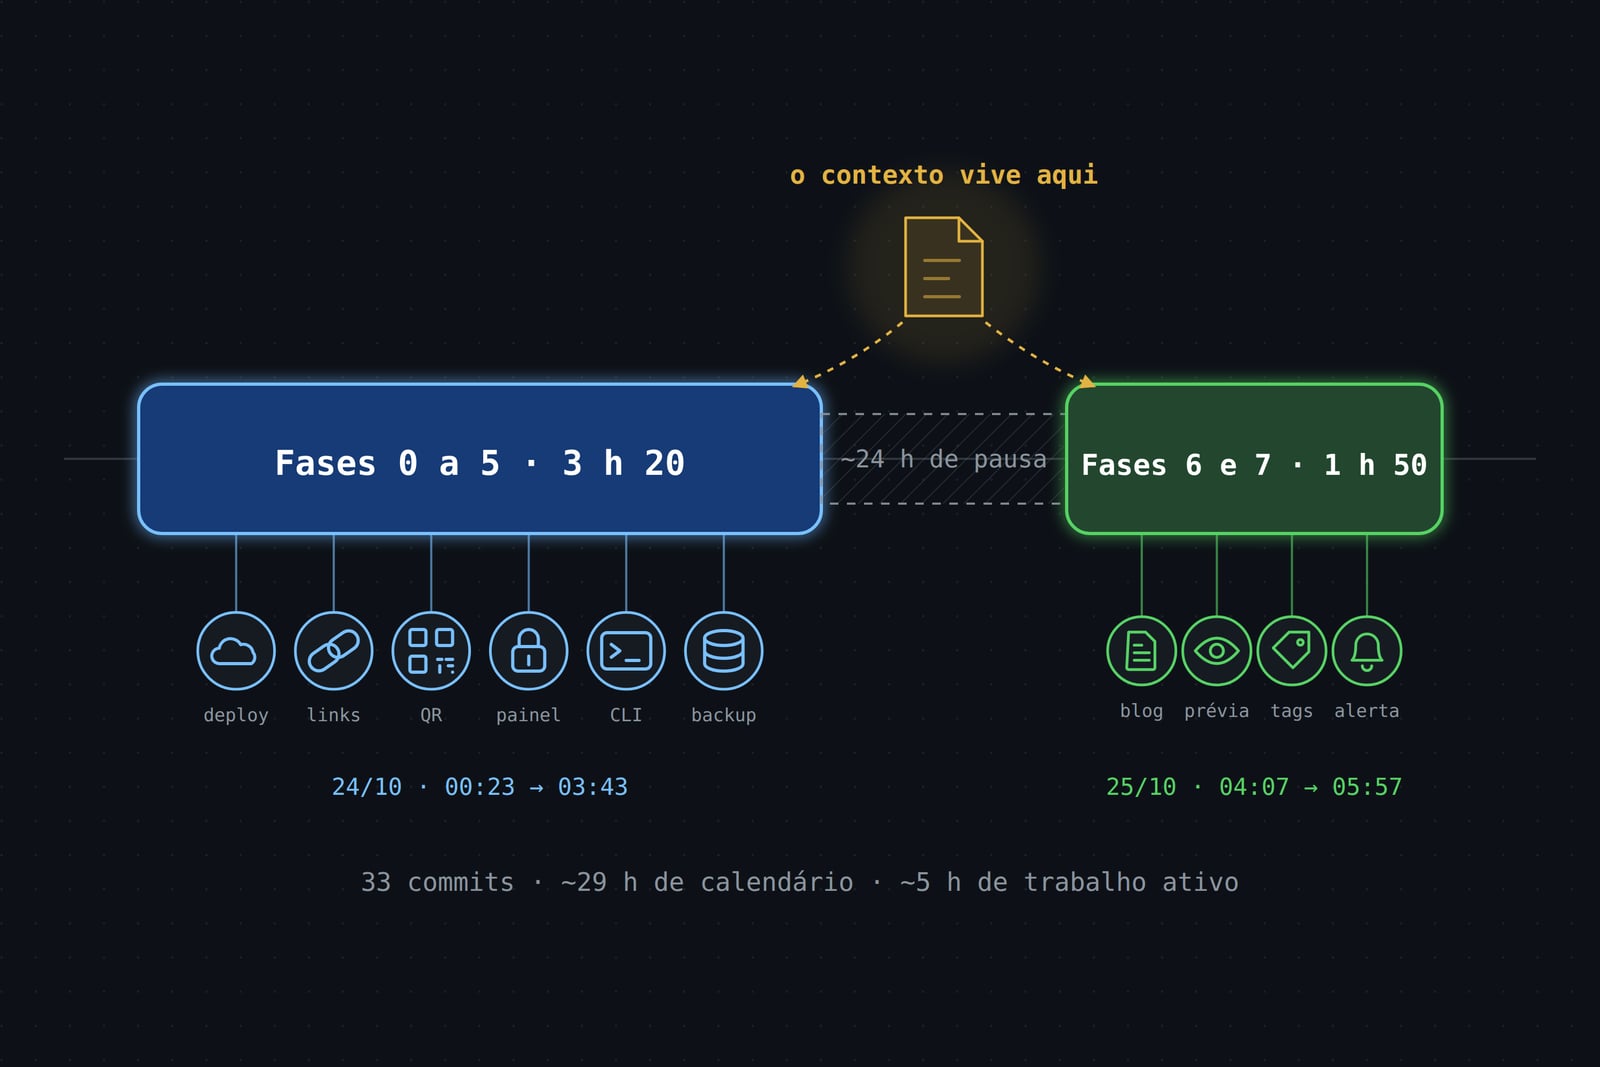
Imagem gerada por IA.
São 33 commits em ~29 horas de calendário, ~5 h de trabalho ativo. Entre os dois blocos, houve uma pausa de cerca de 24 horas, e o trabalho retomou sem perda. Isso só foi possível porque o estado do projeto vivia nos documentos, não na conversa: o agente relê o roteiro e o guia de operação a cada retomada. Houve até mais commits de documentação (13) do que de funcionalidade (11).
Atenção para não superestimar: esse tempo não inclui o que eu fiz fora da conversa, como configurar DNS, painéis e tokens. Essas tarefas manuais, muitas executadas em paralelo durante o processo, não me tomaram mais do que 2 horas adicionais de tempo total.
5. O tamanho do que foi construído
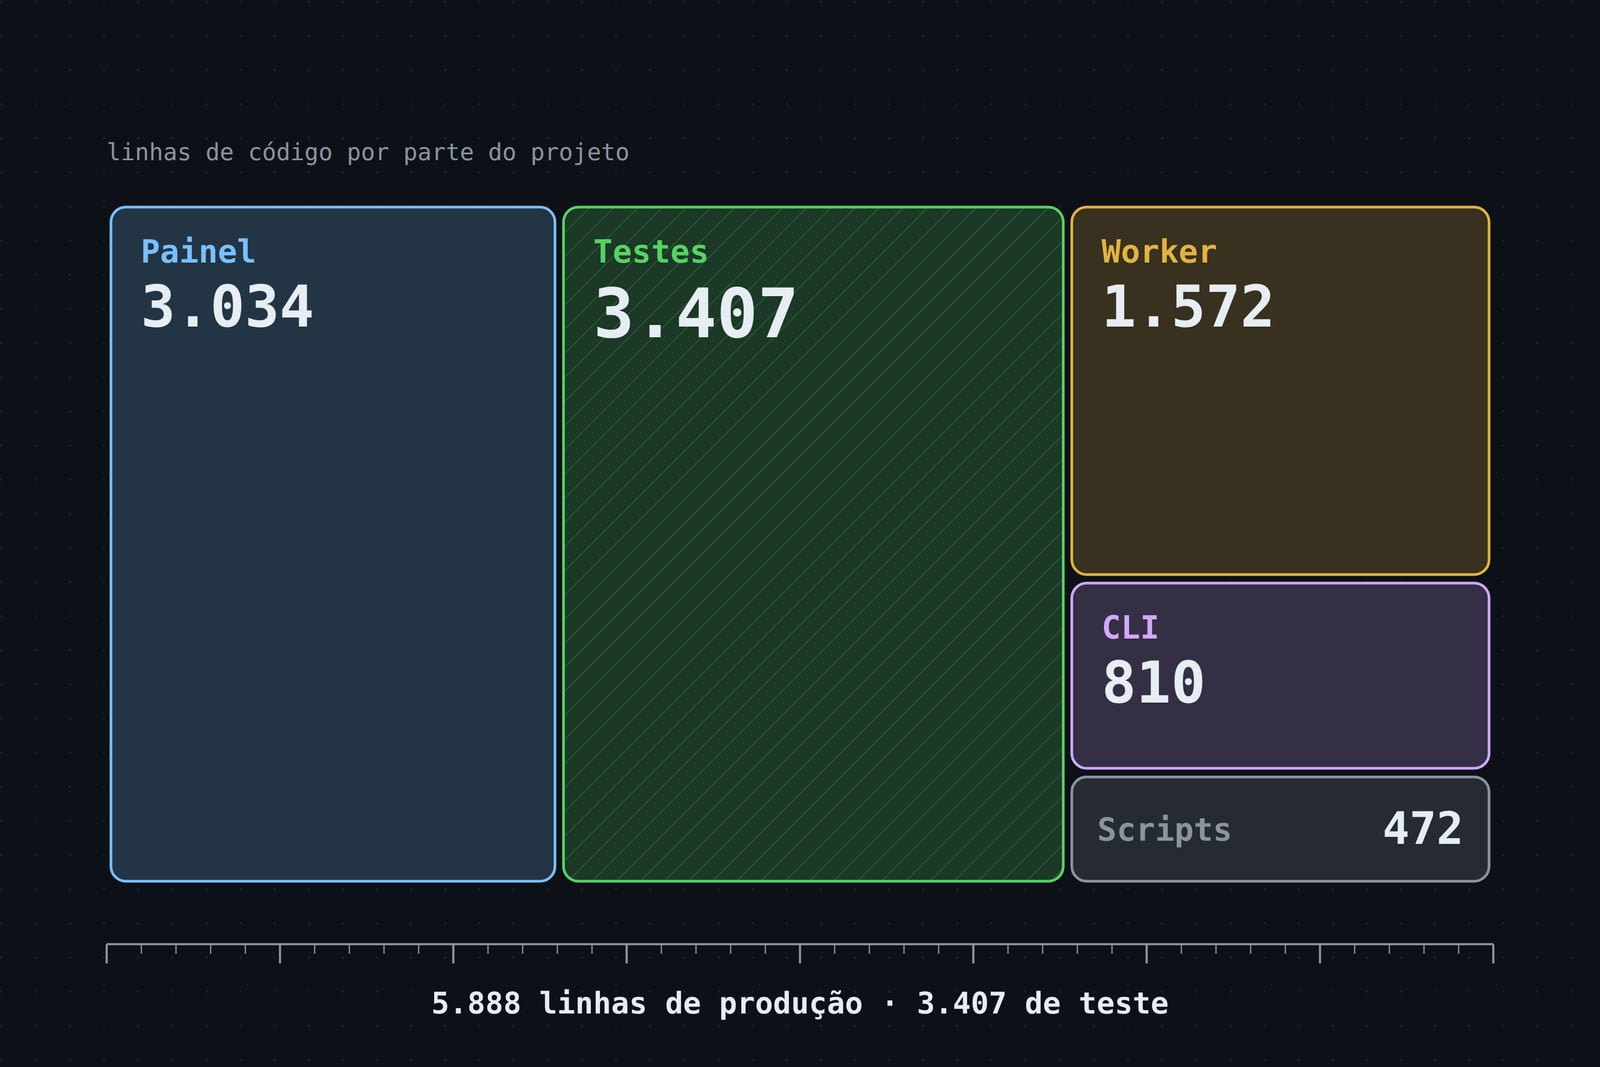
Imagem gerada por IA.
| Código de produção | 5.888 linhas: Worker 1.572 · painel 3.034 · CLI 810 · scripts 472 |
| Testes | 3.407 linhas (razão 0,58 teste por linha de produção; no Worker, 1,41) |
| Documentação | 12 arquivos, ~18,6 mil palavras |
| Dependências de runtime | 2 |
| Tamanho publicado | 139 KiB (38,7 KiB comprimido) |
| Linguagens | TypeScript 3.831 linhas, JavaScript 3.761, CSS 1.511 |
Um dado que me surpreendeu: o coração do serviço tem só 1.572 linhas. O painel administrativo, a parte visual, é mais que o dobro. Num projeto pequeno, o que mais custa código é a interface, não a lógica.
6. O custo da IA
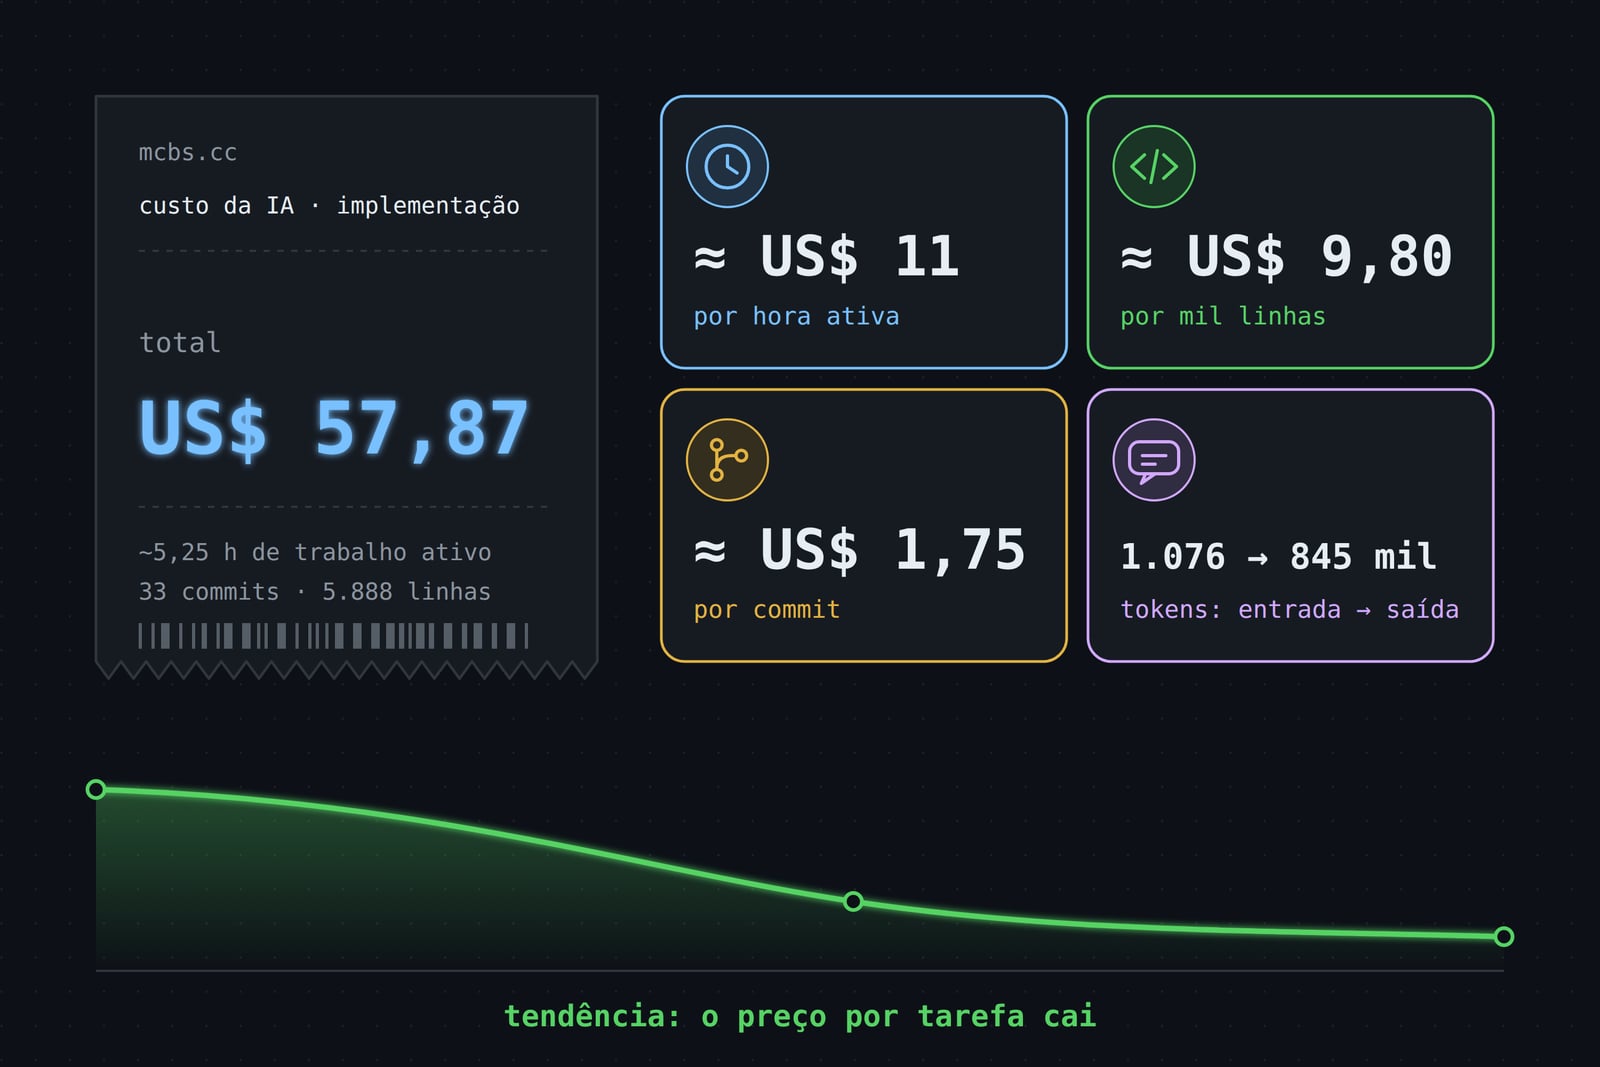
Imagem gerada por IA.
Esta é a pergunta que todo executivo faz primeiro, então vai aqui com o número exato. Medi o consumo com um plugin do VS Code, o
Claude Code Usage (sim, o link também é um mcbs.cc), que mostra o gasto de forma detalhada. No plano
Enterprise que utilizo, a implementação custou US$ 57,87: 1.076 tokens de entrada geraram 845.088 tokens de saída.
Como ler esses números:
- Poucos tokens de entrada, muitos de saída. O contexto do projeto é reaproveitado de uma sessão para outra por cache, que é cobrado à parte e bem mais barato; o que aparece como “entrada” é só o texto novo a cada turno. O custo real é dominado por reler o contexto (barato) e gerar código e documentos (a parte cara). No transcrito da sessão de implementação, as leituras de cache somam ordem de grandeza de 190 milhões de tokens, contra 1.076 de entrada nova.
- Contas de padaria, por cima do número (minhas, não do medidor): ≈ US$ 11 por hora de trabalho ativo (~5,25 h), ≈ US$ 9,80 por mil linhas de código de produção (5.888 linhas), ≈ US$ 1,75 por commit (33 commits). Isso inclui testes, documentação, uma integração com outro repositório e correções.
- O preço de um projeto pequeno, não de uma empresa. Um serviço pronto, testado, documentado e em produção, por menos do que custa uma hora de reunião de muita gente.
O custo do “grátis”. Já escrevi aqui sobre isso em O custo do grátis: serviços “gratuitos” cobram em outra moeda (dados, atenção, tela de login, ou o dia em que viram pagos, como aconteceu com os encurtadores que me levaram a construir o meu). O experimento mostra o outro lado: construir com IA tem um preço visível e pequeno, e a tendência é esse preço cair, com modelos mais eficientes e planos mais baratos. Num plano pessoal, com assinatura de valor fixo, o custo dessa implementação seria irrisório, em parte pelo subsídio que comento no meu outro post, e em parte pela mecânica de limites e quotas das contas pessoais. O que não cai sozinho é o custo de decidir bem e verificar: esse continua sendo humano.
Para executivos: compare o custo da IA com o custo do tempo das pessoas que ela libera (ou do problema que ficou sem resolver por falta de tempo). E acompanhe a curva: o preço por tarefa está caindo, e o gargalo está migrando do custo de produzir para a qualidade de quem especifica e verifica.
7. Qualidade: o que os números dizem (e o que escondem)
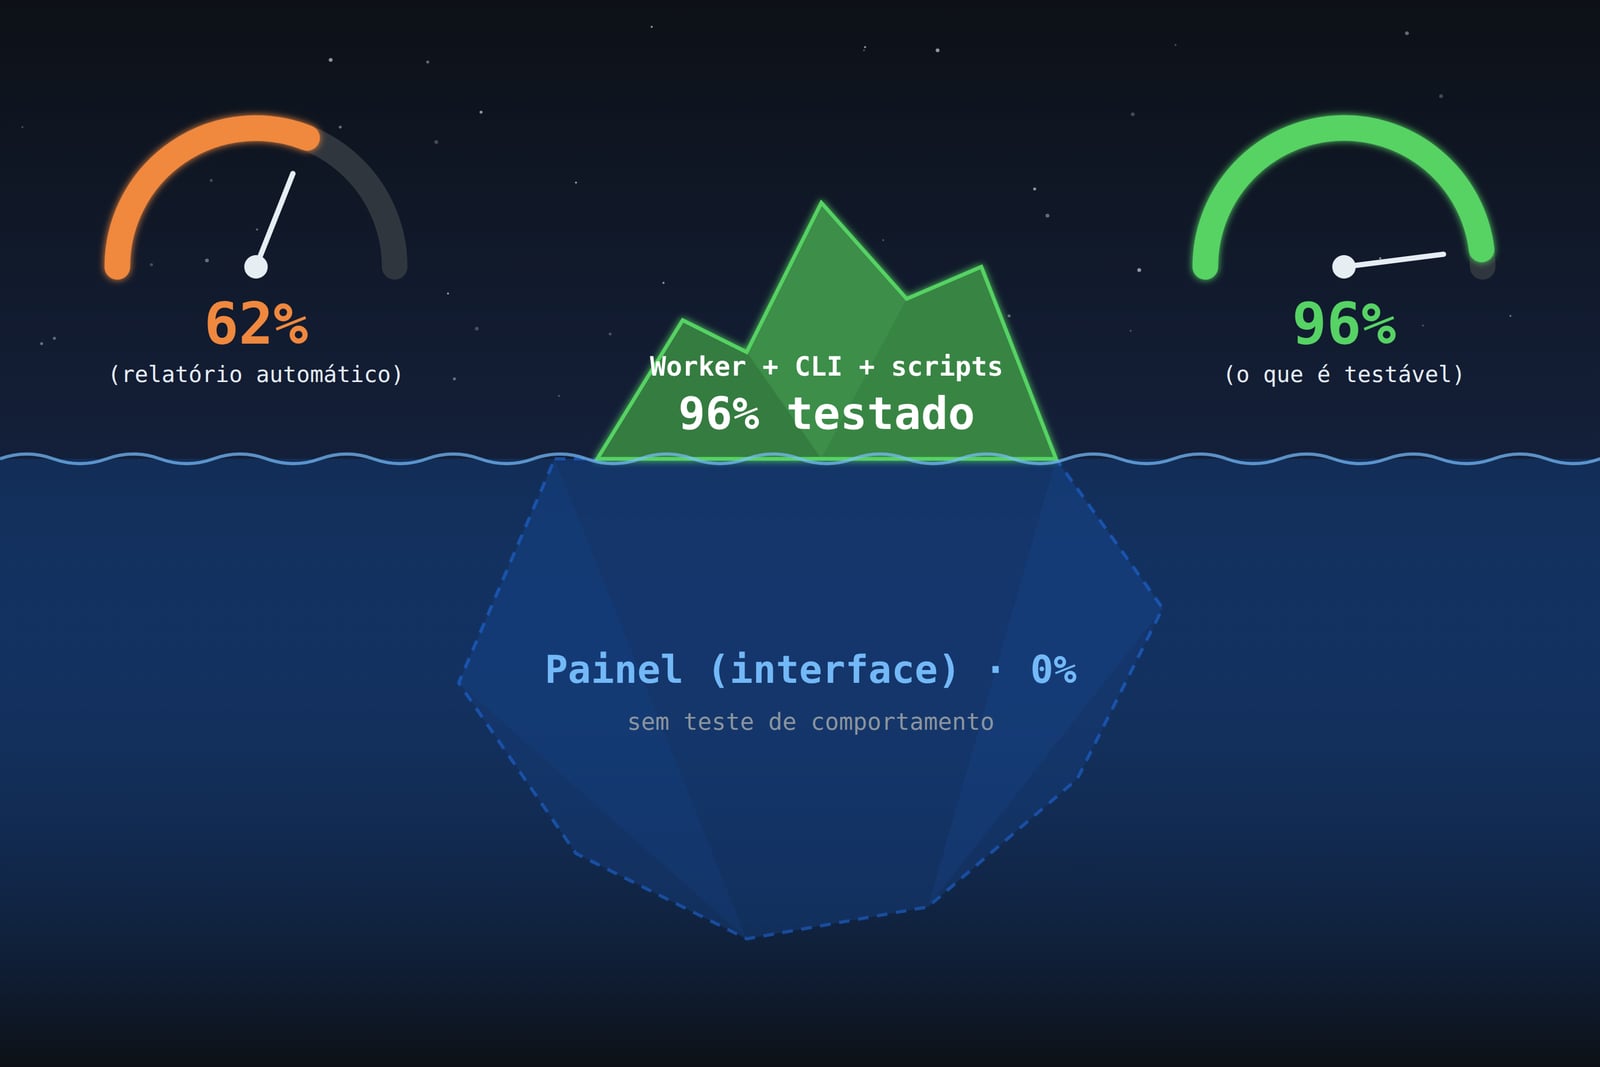
Imagem gerada por IA.
Cobertura de testes. São 317 testes que rodam em ~5 segundos, em dois ambientes: o ambiente real da Cloudflare, com banco de dados de verdade, e Node para a linha de comando.
| Área | Linhas cobertas |
|---|---|
| Worker | 98,0% |
| CLI | 90,8% |
| Scripts | 96,1% |
| Painel (interface) | 0% |
| Tudo, exceto a interface | 95,7% |
| Tudo, com a interface | 62,0% |
O número que você veria num relatório automático é 62%. O número real do que é testável é 96%. E o que o relatório esconde é exatamente onde mora o risco: a interface não tem teste de comportamento, e é metade do código. É o meu ponto fraco declarado. Se esse sistema fosse crítico, esse seria o próximo investimento.
Para executivos: peça sempre o número desagregado. Uma média alta pode esconder a metade do sistema sem rede de proteção. Isso vale para código gerado por IA e para código humano.
Complexidade ciclomática (mede quantos caminhos diferentes uma função pode seguir; quanto maior, mais difícil de testar e manter): em 329 funções, a média é 3,67, a mediana 2, e 81,5% são simples. A mais complexa chega a 34, e as mais complexas são sempre as mesmas: validação de entrada e despacho de comandos, que ramificam por natureza. Não há “função monstro” com regra de negócio escondida.
Higiene estática. Zero TODO, zero supressões de verificação de tipos, zero asserções inseguras, 1 exceção de lint em todo o
projeto, e 0,44% de duplicação. Uma verificação única (npm run check) roda lint, checagem de tipos e os 317 testes.
8. Segurança: onde o agente precisou de supervisão
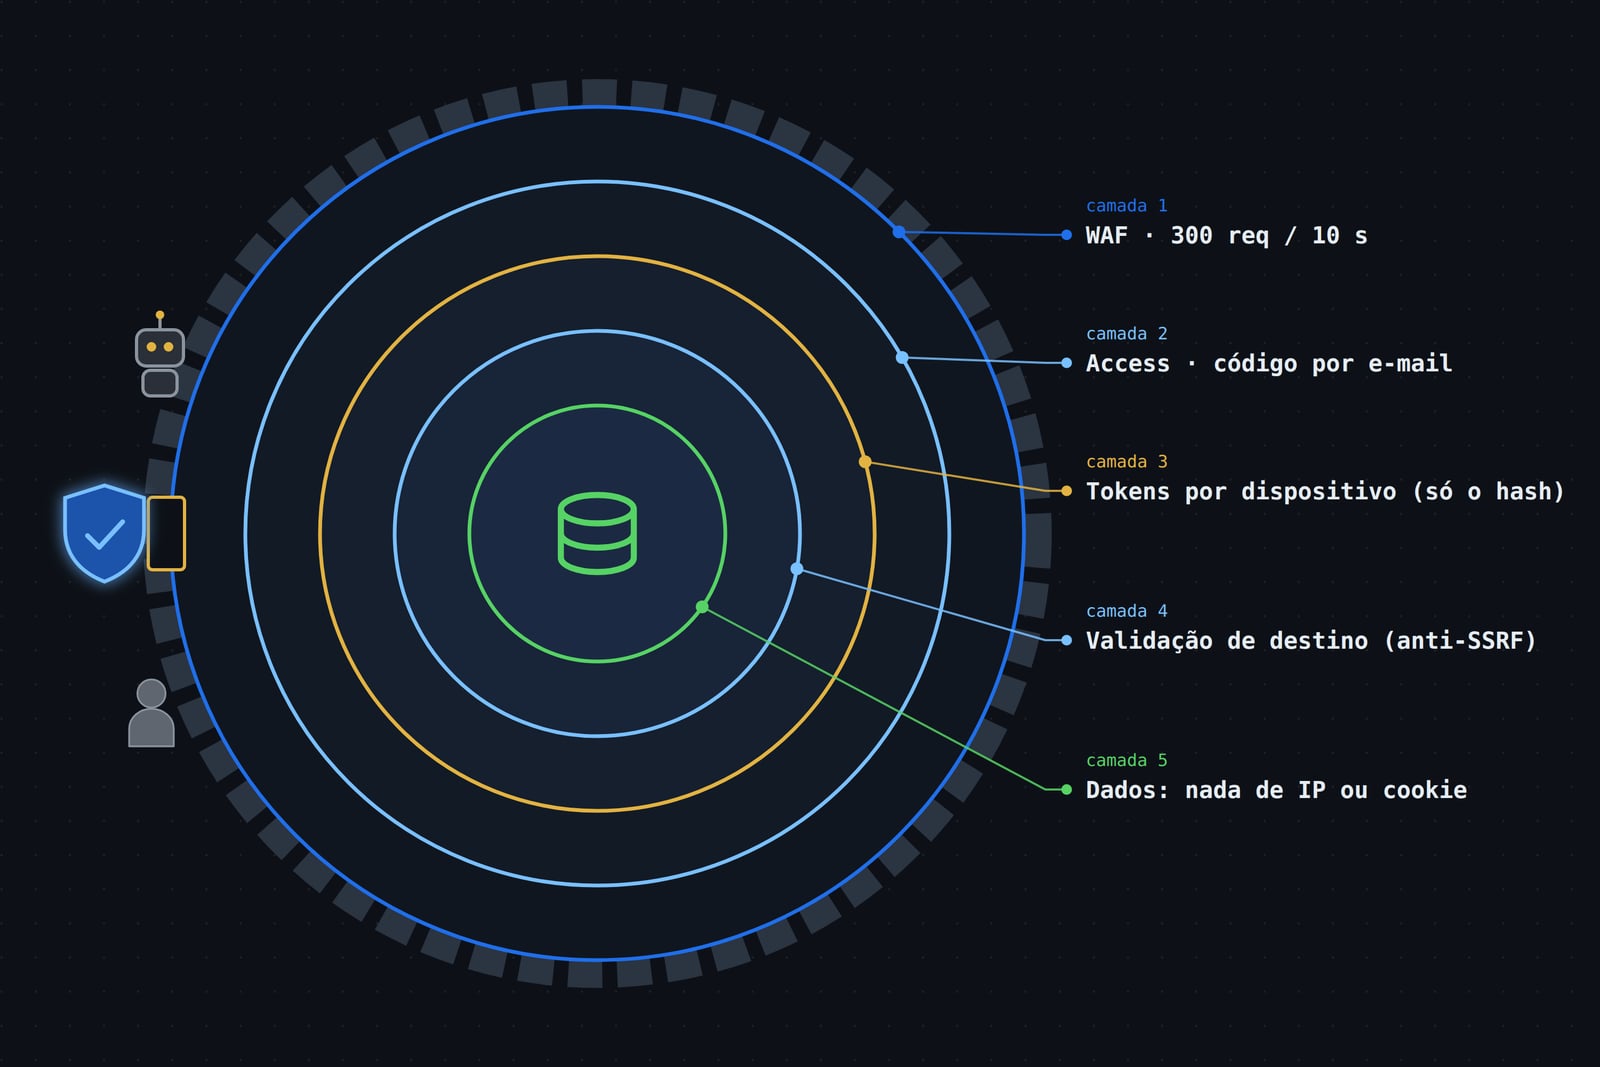
Imagem gerada por IA.
Esta é a parte do experimento que mais me interessava como executivo, porque é onde o custo de um erro deixa de ser teórico. O que foi implementado, em camadas:
- Autenticação por camadas separadas. O painel fica atrás do Cloudflare Access (código por e-mail); as máquinas (linha de comando, blog, atalho do iPhone) usam tokens, um por dispositivo. Se eu perder o celular, revogo um token sem derrubar os outros. O servidor guarda só o hash dos tokens, nunca o valor, e nega tudo se a configuração estiver ausente ou inválida (“falha fechada”).
- WAF com limite de requisições. Uma regra na zona limita 300 requisições a cada 10 segundos por IP. A escolha do número foi uma conversa de verdade: eu perguntei se 1.000 não seria mais folgado, e a análise mostrou que um único IP faria ~100 requisições por segundo e consumiria a cota diária do serviço em ~17 minutos. Com 300, o abuso de um IP só já é contido. Os limites e as ressalvas (o bloqueio dura 10 s no plano gratuito, e ataque distribuído passa) estão escritos no guia de operação.
- Proteção contra SSRF. O serviço recusa encurtar endereços internos (
localhost, redes privadas, o próprio domínio), para que não seja usado como ponte para sistemas que não deveriam ser alcançados. - Privacidade por construção. Nenhum IP, cookie ou impressão digital nas estatísticas. Links sensíveis podem ser privados.
- Política de conteúdo rígida no painel (CSP): nada de script ou estilo embutido, nada de terceiros, nada de montar tela com dado da API sem tratamento. Um teste automático quebra se alguém violar isso.
- Nada é apagado. Links arquivados nunca têm o endereço reutilizado, para um QR impresso nunca passar a apontar para outro destino.
- Backup e plano de recuperação. Backup diário do banco para o GitHub, e um guia de operação com o passo a passo de restaurar tudo ou um link só.
E duas lições de segurança, que são lições sobre colaboração, não sobre o modelo:
- O assistente errou, e o humano pegou. Uma das primeiras versões do guia de operação trazia uma instrução que revogaria o token do iPhone sem querer. Isso virou uma regra: a lista de tokens vive num arquivo local, como fonte única. E, no WAF, eu mesmo vi numa captura de tela que o recurso que o agente descrevia era do plano Enterprise; a documentação foi corrigida duas vezes.
- Segredos não passaram pela conversa. Os tokens foram gerados e enviados direto para o cofre (o GitHub e a Cloudflare), sem serem exibidos na tela nem no histórico.
Para executivos: o agente aplica bem as boas práticas que conhece e documenta os trade-offs. Mas a definição do que é “aceitável” (quanto de risco, quanto de abuso, quanto de custo) continua sendo uma decisão humana. Aqui, ela veio de perguntas curtas, não de expertise de segurança.
9. Skills: quase nenhuma, e isso diz algo
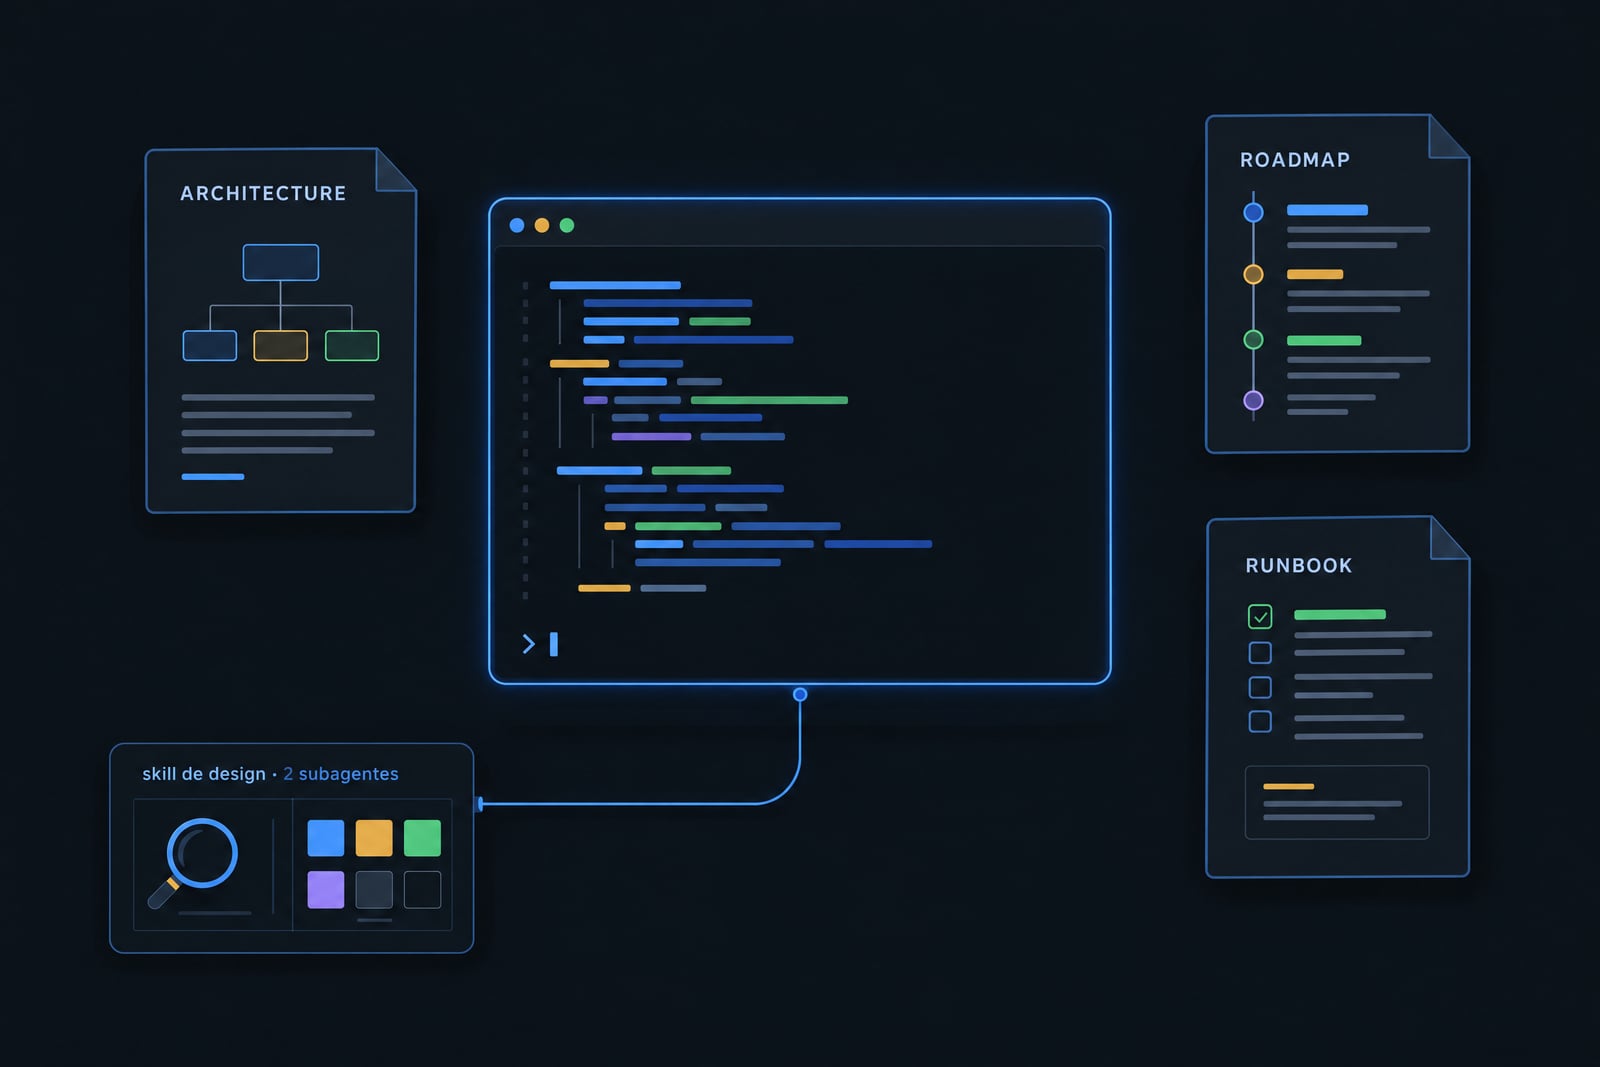
Imagem gerada por IA.
Uma pergunta que ouço muito é “quais skills você usou?”. A resposta honesta: uma.
- Skill
impeccable, usada na construção do painel. Ela conduz uma entrevista de design (duas perguntas: quais tarefas o painel precisa facilitar, e qual a direção visual; escolhi um “painel escuro”) e produz documentos de produto e de design. Dela vieram dois subagentes: um revisor de acabamento, que checou a interface pronta contra o contrato de design e devolveu correções (contraste, rótulos, estados desabilitados), e um documentador, que registrou o sistema de design a partir do que foi entregue, não das intenções.
O resto do projeto, do Worker ao QR, ao backup, ao blog e ao monitor, foi feito sem skill nenhuma: modelo, terminal e documentos. A conclusão que tiro: skills e agentes especializados valem muito onde existe um domínio com critério estético ou de método (design, no caso). Para engenharia convencional, um bom plano e uma boa disciplina de verificação pesaram mais do que ferramental extra.
10. Onde o humano foi (e continua sendo) indispensável
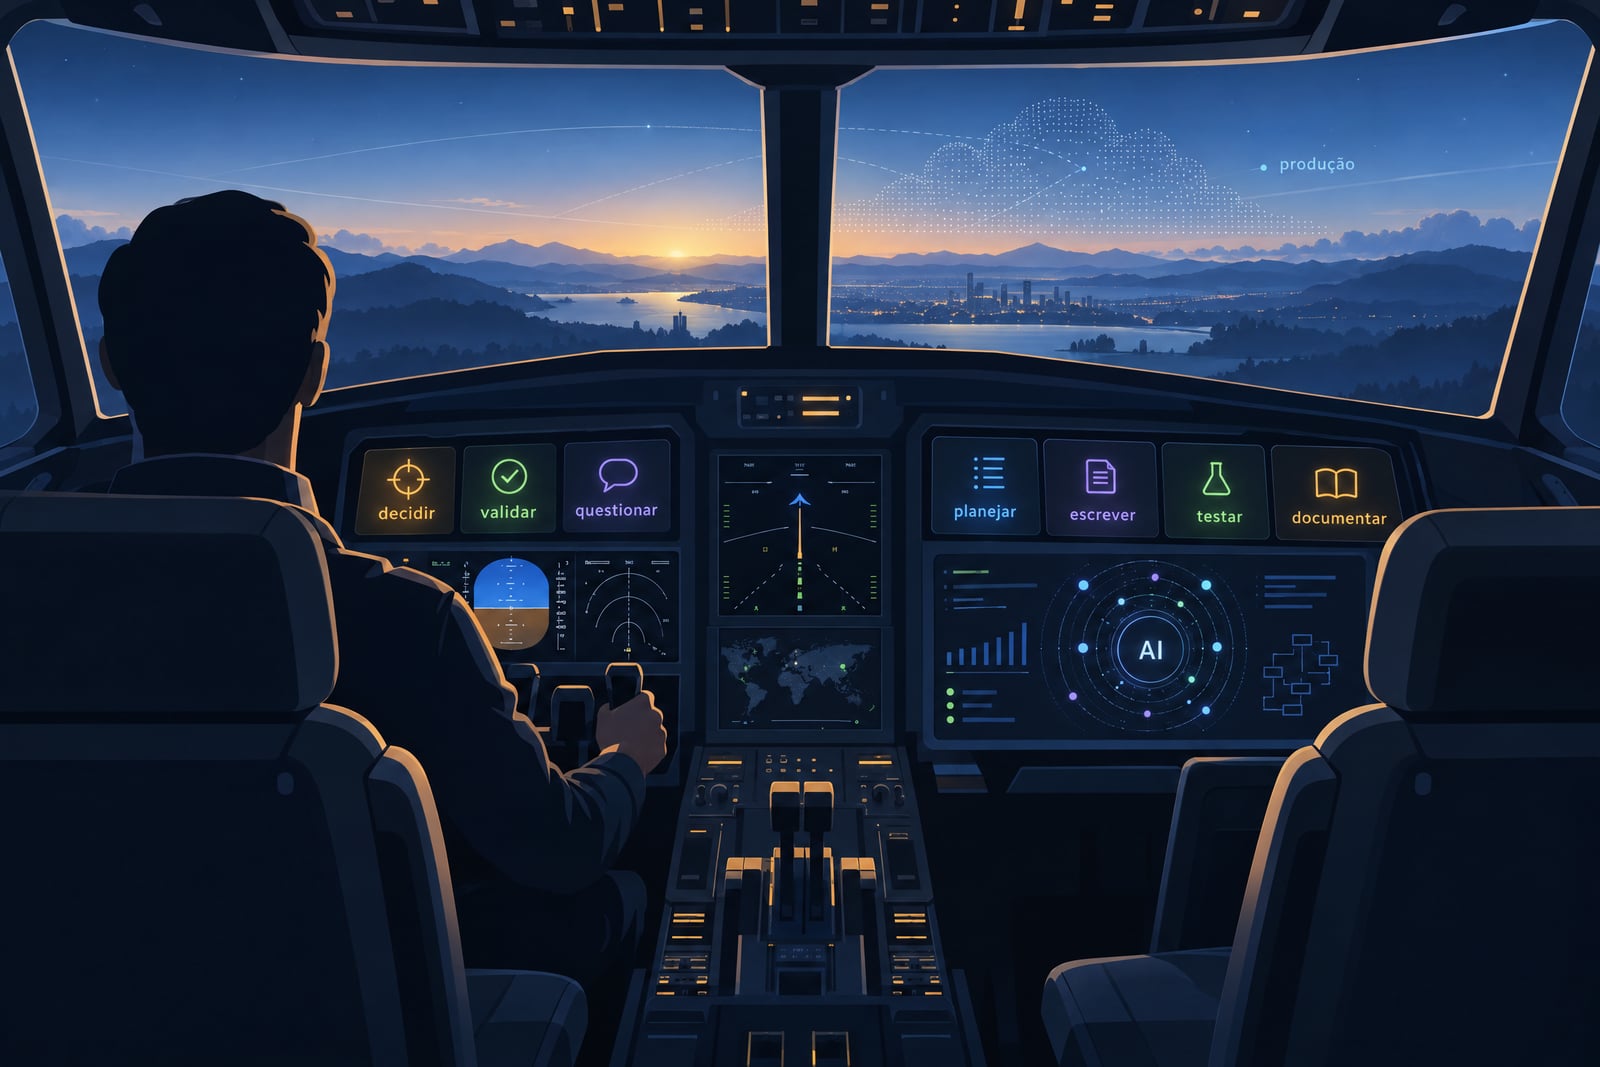
Imagem gerada por IA.
O experimento deixou muito claro o que não foi automatizado, e vale mapear porque é onde está o seu papel de liderança:
- Decidir. Escopo, prioridades, o que cortar. Cortei as URLs curtas para arquivos e fotos (exigiriam armazenamento pago e tratamento de abuso) e escolhi que “coleção” fosse só uma etiqueta.
- Executar o que exige acesso e identidade. Login na conta, DNS, criar a aplicação de acesso, gerar tokens, instalar o atalho no iPhone.
- Validar no mundo real. O agente diz “pronto”; eu abri o painel, criei links, escaneei o QR, conferi o resultado. Sete capturas de tela valeram mais que páginas de explicação.
- Questionar. “Por que não mais curto?”, “isso não vai dar problema com 150 conteúdos?”, “não entendi a D7, me explique”. Perguntas curtas mudaram o desenho várias vezes.
- Revisar antes de aplicar. Para a integração com o blog, pedi: “escreva, mas não implemente, quero revisar”. O agente entregou um documento de revisão com oito decisões, as provas, o que não foi verificado e como reverter, mais um patch já validado. Só aprovei depois de entender.
11. O que deu errado (e por que é bom contar)
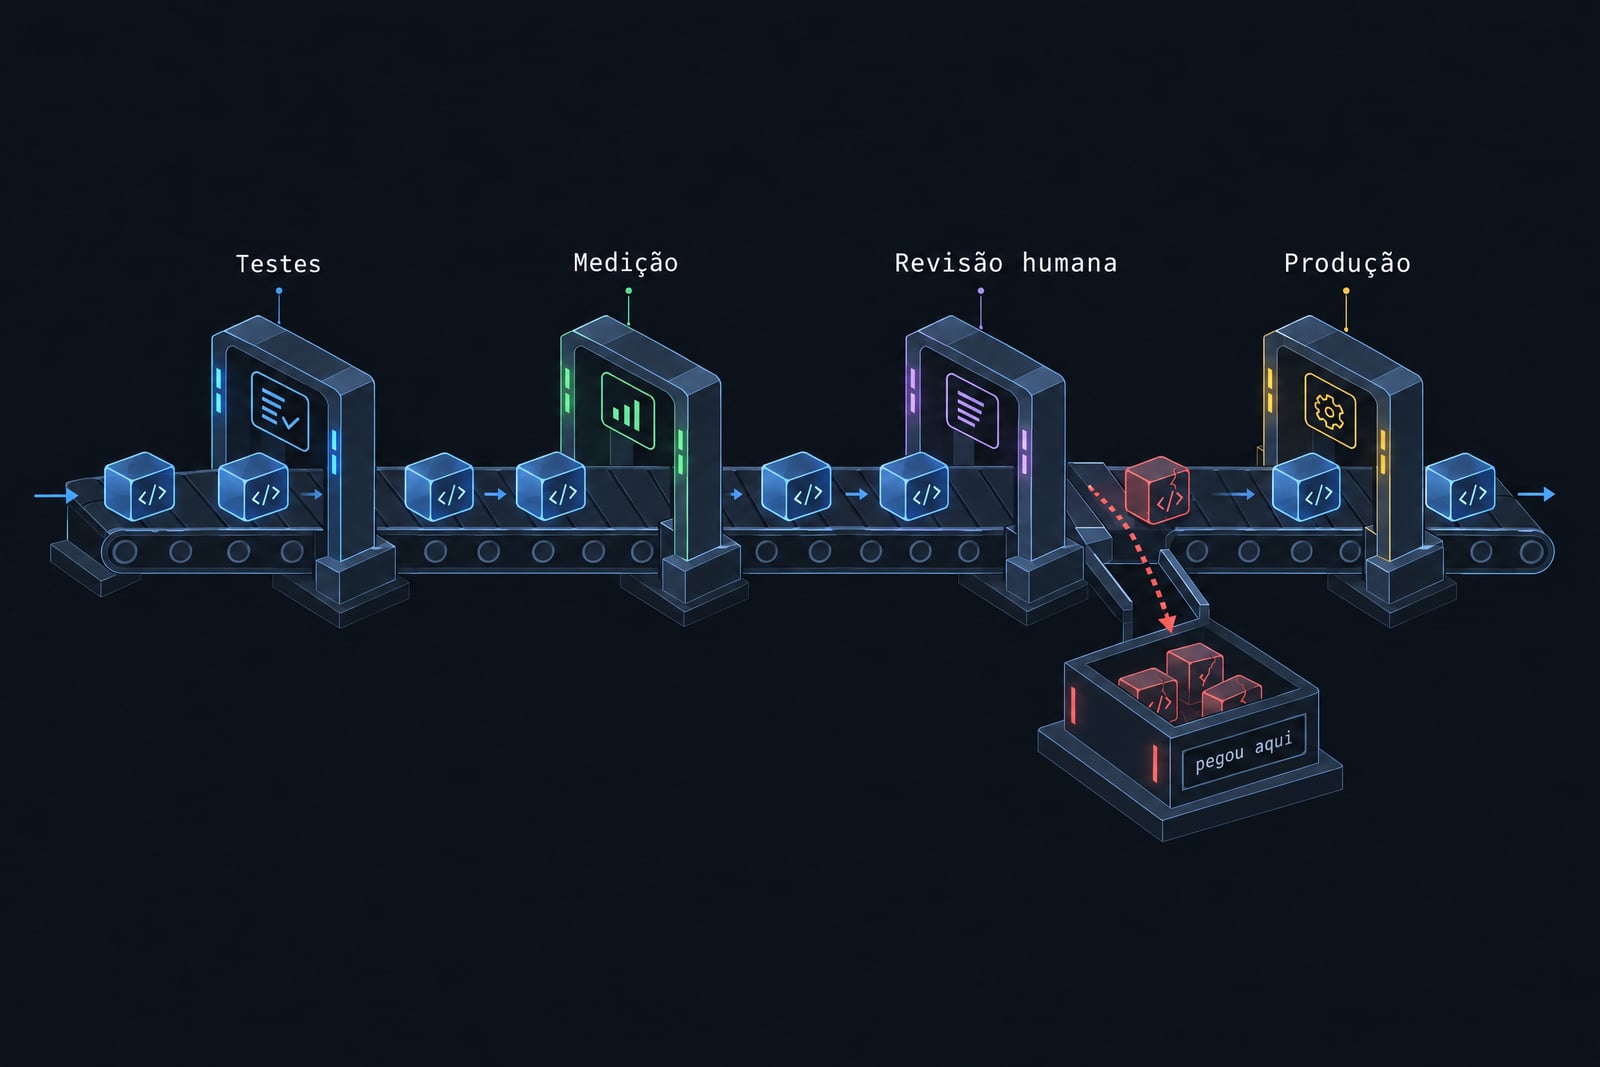
Imagem gerada por IA.
- O QR estourava o orçamento de processamento (10 ms por requisição no plano gratuito). Em vez de otimizar no escuro, foi medido, a escolha automática de padrão foi trocada por uma fixa, e o pior caso ficou abaixo de 9 ms.
- O alerta que eu pedi não existia. Eu queria um alerta de erro pela notificação nativa da Cloudflare; a documentação mostrou que, no plano gratuito, ela não cobre esse caso. A solução foi uma sonda externa, no GitHub, que abre um chamado quando o serviço falha e o fecha quando volta.
- Um serviço que cai não consegue avisar que caiu. Por isso o monitor roda fora do Worker.
- Os números do próprio post: na primeira versão do levantamento de métricas, o assistente escreveu um dado de cobertura sem conferir; ao rodar a conta, estava errado e foi corrigido. É o mesmo padrão do projeto: toda afirmação sobre o mundo real foi verificada com um comando antes de virar documentação.
Para executivos: a pergunta certa não é “o agente erra?”. Ele erra, como qualquer pessoa. A pergunta é: o processo detecta o erro antes de ele chegar a produção? Testes, medições, revisões e validação humana são o seguro.
12. O que levo para a estratégia de adoção
Imagem gerada por IA.
Entrei no experimento achando que a pergunta era “o modelo consegue?”. Saí com outra: “a minha organização sabe especificar, verificar e responder pelo que a IA produz?” A primeira tem resposta técnica e melhora a cada trimestre. A segunda é de liderança, e é a que decide se a adoção vira ganho ou risco. Nove aprendizados, direto ao ponto:
- Comece por um problema seu, real e pequeno. O aprendizado vem do atrito, não da demonstração. Um encurtador de URLs parece trivial e tocou infraestrutura, segurança, custo, operação, interface e integração.
- Pense caro, execute barato. Um modelo mais forte planejando (38 min), um mais econômico executando (~5 h), e um plano específico entre os dois. A economia não está em usar o melhor modelo em tudo, nem o mais barato em tudo.
- O custo é pequeno, e a tendência é cair. US$ 57,87 de IA por um serviço completo, testado e em produção, em ~5 h de trabalho ativo; num plano pessoal, seria irrisório. Compare com o custo do tempo das pessoas que a IA libera, e com o dos problemas que ficaram sem solução por falta de tempo.
- Documentação deixa de ser burocracia e vira infraestrutura. É a memória compartilhada que sobrevive a pausas, trocas de sessão e de modelo. O que era “boa prática” virou requisito.
- O gargalo se desloca para decidir e verificar. Produzir código ficou barato; saber o que construir, que risco aceitar e como provar que funciona continua humano.
- Peça a métrica desagregada. 62% de cobertura parecia razoável; 96% do que é testável e 0% da interface contava a história real. Vale para código gerado por IA e para código humano.
- Segurança é decisão humana executada por IA. O agente aplica bem as práticas que conhece e registra os trade-offs; quanto risco, quanto abuso e quanto custo são aceitáveis continua sendo seu.
- Pergunte se o processo pega o erro, não se o agente erra. Ele erra, como qualquer pessoa. Testes, medições, revisão e validação humana são o seguro.
- Governança vira o tema central: quem aprova, quem verifica, quem responde.
E uma ressalva de honestidade: isto é um projeto pequeno, sozinho, com requisitos claros e sem legado. Não prova que o mesmo ritmo vale para um sistema crítico de uma grande organização, com integrações antigas, times grandes e regulação. Prova que a mecânica funciona, e que as perguntas de governança passam a ser as mais importantes.
Epílogo curto
O link que você usou para compartilhar este post passou por um Worker de 1.572 linhas que eu nunca li inteiro. E está tudo bem: a sensação não é de “perder o controle”, é de mover o controle de escrever para especificar e verificar.
Em breve, adaptarei o projeto para open-source e vou deixar disponível no meu GitHub. Por enquanto, ainda está privado, mas os documentos de arquitetura e de operação estão resumidos neste post.